

Paritok 4B
Kompresja tokenów dla agentów programistycznych AI
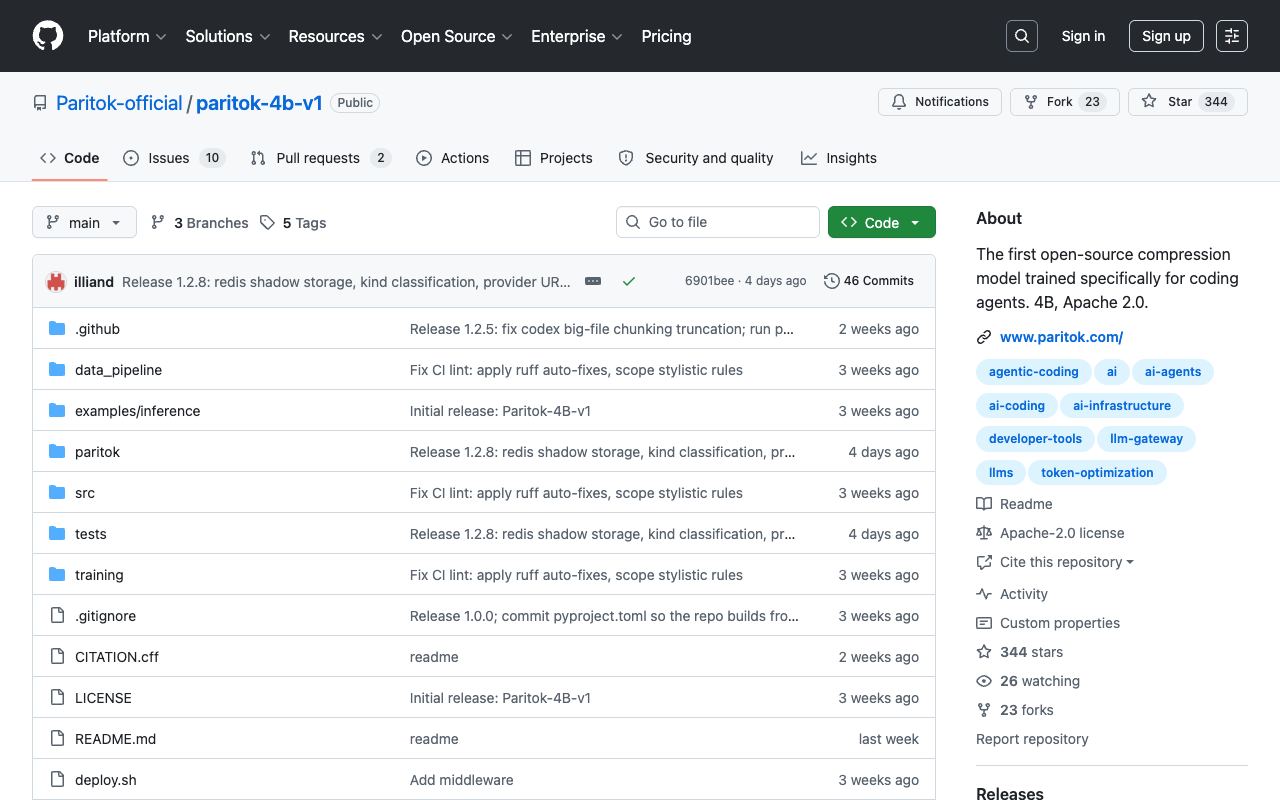
Paritok optymalizuje korzystanie z modeli LLM przez programistów, przechwytując żądania wysyłane przez agentów programistycznych do API modeli i kompresując kontekst wejściowy przed przekazaniem go dalej. Takie podejście warstwy pośredniej zmniejsza liczbę tokenów o około 74% przy typowych obciążeniach, a podczas dłuższych sesji oszczędności mogą sięgać 95%.
Najważniejsze funkcje
- Kompresja tokenów na poziomie 74–95% przy zachowaniu 86,5% skuteczności rozwiązywania zadań w SWE-bench Verified
- Model wytrenowany na 45 000 rzeczywistych przebiegów agentów programistycznych, aby rozumiał sposób pracy deweloperów
- Bezstratny dla kontekstu mechanizm kompresji z wbudowanym narzędziem
expand_context, które w razie potrzeby pozwala odzyskać informacje - Konstrukcja uwzględniająca kod, która filtruje ponad 70 schematów narzędzi za pomocą osadzeń semantycznych
- Adapter 4B LoRA do samodzielnego hostowania na licencji Apache 2.0
Rozwiązanie jest przeznaczone dla programistów korzystających z agentów takich jak Claude Code, Cursor lub OpenHands, którzy chcą obniżyć koszty API i opóźnienia. Paritok może działać bezpłatnie na własnej karcie GPU z 24 GB pamięci albo w opcjonalnej usłudze hostowanej rozliczanej za każde żądanie. Subskrypcja nie jest wymagana.
Podobne narzędzia
Zobacz alternatywy →
Roomote
FreemiumAutonomiczny agent AI, który pisze kod i tworzy pull requesty
Bito
FreemiumAsystent kodowania AI znający kontekst całej bazy kodu
Code Snippets AI
FreemiumCzat AI o kodzie połączony z biblioteką fragmentów
Komentarze(0)
Zaloguj się, aby skomentować